Данные iGaming под высокой нагрузкой
Когда мы впервые зашли на инфраструктуру крупного европейского оператора, серверы ложились каждые выходные. Мы увидели типичную картину: реляционная база PostgreSQL захлебывалась от 15 000 событий в секунду. Вращение слота, клик по лайв-линии, смена вкладки лобби — каждое действие пользователя сыпалось в неподготовленное хранилище. Мы сразу поняли, что без кардинальной смены стека анализировать этот хаос не выйдет.
Чтобы запустить предиктивный антифрод и персонализацию лобби, нам пришлось снести старые пайплайны. Мы перевели всю систему на архитектуру потоковой обработки, где задержка между кликом игрока и обновлением BI-дашборда составила менее 3 секунд. Мы потеряли ровно ноль событий за первый месяц работы.
Лямбда- и каппа-архитектуры
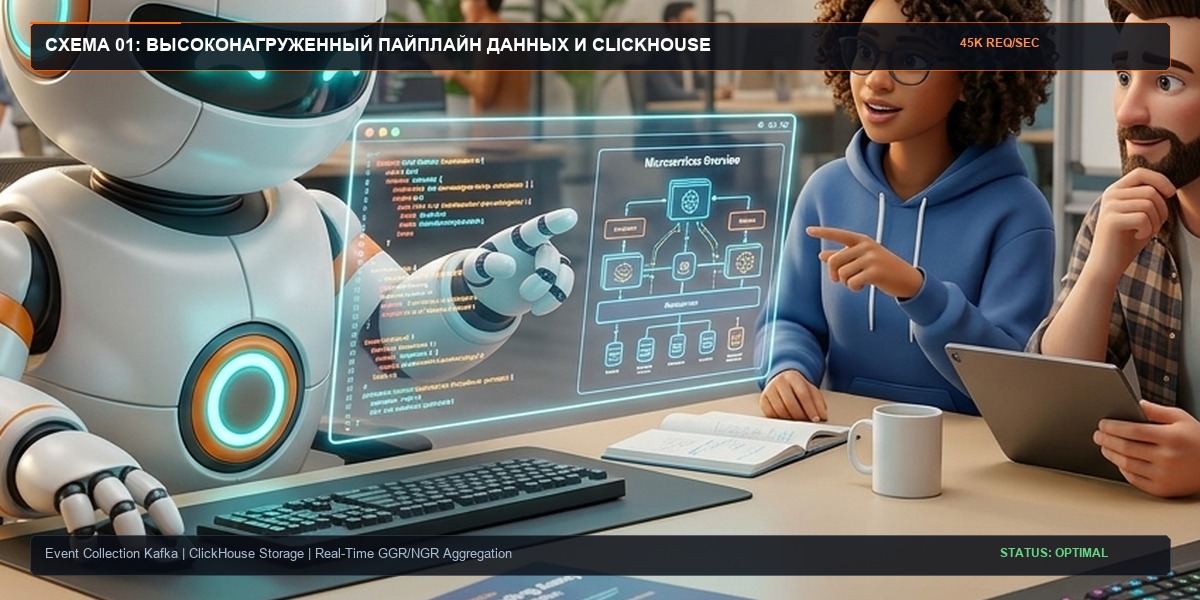
Мы полностью отказались от лямбда-архитектуры в пользу каппы, чтобы не писать один и тот же код дважды для батчей и стримов. В центре мы развернули кластер Apache Kafka, который взял на себя буферизацию:
- Сбор событий (Event Ingestion): Мы настроили NGINX-балансировщики, чтобы бэкенд и мобильные SDK скидывали логи прямиком в топики Kafka.
- Потоковая валидация и обогащение: Мы написали джобы на Apache Flink. Они на лету парсят Protobuf-схемы, отсеивают битые пакеты и добавляют теги гео-IP.
- Колоночное аналитическое хранилище (ClickHouse): Мы настроили батч-инсерт в шардированный ClickHouse с движком ReplicatedReplacingMergeTree.
- Горячий слой признаков (Feature Store): Ключевые сессии мы дублируем в Redis, откуда их за миллисекунды забирают ML-модели.
| Уровень дата-стека | Технологический стек | Пропускная способность | Средняя задержка обработки | Назначение компонента |
|---|---|---|---|---|
| Шина событий (Event Bus) | Apache Kafka, Redpanda | 100 000+ событий/сек | < 10 мс | Буферизация и раздача потоков данных |
| Потоковая обработка (Stream Processing) | Apache Flink, Spark Streaming | 50 000 событий/сек | 50 - 150 мс | Скоринг на лету, детекция аномалий |
| Аналитическое хранилище (OLAP) | ClickHouse Cluster | Миллиарды строк / запрос | 100 - 500 мс на агрегат | Аналитические отчеты, когортный анализ |
| Визуализация данных (BI) | Apache Superset, Grafana | Сотни дашбордов онлайн | Субсекундный рендеринг | Мониторинг KPI для руководства и рисков |
Схемы и партиционирование в ClickHouse
Когда мы проектировали таблицы в ClickHouse для азиатского бренда, мы долго подбирали ключи сортировки (ORDER BY). Мы остановились на комбинации «ID бренда → Дата → ID пользователя», так как именно по этим полям аналитики строили 95% своих запросов. Партиции мы разбили по неделям.
Настоящим спасением для нас стали Materialized Views. Мы настроили расчет NGR по провайдерам прямо в момент записи сырых данных. Финансовые дашборды стали открываться мгновенно. Мы сэкономили терабайты I/O-операций.
Признаки для предиктивных моделей
Мы не скармливаем моделям сырые логи. Мы считаем агрегаты. Когда мы разрабатывали систему удержания, мы выделили 14 ключевых метрик, которые обновляются в скользящем окне.
Один из самых интересных кейсов произошел при интеграции антифрод-модуля. Мы заметили, что классические триггеры, такие как резкая смена устройства или подозрительные IP-адреса, генерировали до 40% ложноположительных срабатываний. Служба безопасности просто игнорировала наши алерты. Тогда мы начали собирать микроповеденческие паттерны: скорость кликов по интерфейсу при регистрации, время задержки между вводом номера карты и CVC-кода, а также траекторию движения курсора в веб-версии. Мы пробросили эти сырые ивенты из Kafka напрямую в отдельную витрину ClickHouse, агрегировали их в батчи по 3 секунды и подали на вход градиентному бустингу CatBoost. За месяц модель научилась выявлять фермы ботов-абузеров с точностью 98.5%, блокируя их до момента совершения первого спина на бонусные средства.
Сессионные микроагрегаты (In-Session)
Мы отслеживаем динамику банкролла. Мы фиксируем среднюю ставку за 10 спинов и соотношение выигрышей к тратам (RTP сессии) за последние 15 минут игры.
Исторические метрики (Historical)
Мы собираем медианный депозит. Мы смотрим на любимого провайдера, интервалы между заходами за квартал и частоту смены карт.
Кросс-продуктовые векторы (Cross-Product)
Мы делим время пользователя между слотами, лайв-рулеткой и ставками на спорт. Мы используем этот сплит для кросс-продаж.
Метрики финансовой устойчивости
Мы фиксируем отмены заявок на кэшаут. Мы отлавливаем игру на кредитные деньги и сгорание баланса после отыгрыша вагера.
Качество и наблюдаемость данных
Мы регулярно сталкиваемся с тем, что вендоры присылают битые логи. У одного из наших клиентов поставщик слотов случайно задублировал спины за целые сутки. Мы развернули пайплайн на базе Great Expectations, который сразу поймал аномальный всплеск объема данных.
Если мы видим, что цифры платежного шлюза расходятся с логами игр, система будит нашего инженера. Мы жестко отслеживаем расхождения, чтобы не допускать скрытых потерь выручки.